从 AI 火焰图分析到经验证的修复:用 OpenResty XRay 驱动 Coding Agent 性能优化闭环

性能优化的核心诉求向来明确:从复杂的 CPU 采样数据中,得出清晰的诊断结论与可验证的修复方案。 借助 OpenResty XRay AI Assistant Skill,Claude Code、Codex、Cursor 等 AI coding agent 能够直接对接 OpenResty XRay——自动识别目标进程、触发分析器,基于真实运行时采样完成火焰图的 AI 分析,并将热点精准映射至具体的源文件与行号。
对于已经在目标机器上部署了 OpenResty XRay 的团队而言,这一组合的真正价值在于:它补齐了 coding agent 缺失的运行时上下文。 AI 不再依赖对静态代码的空泛猜测,而是基于动态追踪采集到的真实采样来定位瓶颈、提案重构。本文以一个贴近生产的 Checkout 边缘服务为例,演示 coding agent 如何在 OpenResty XRay 真实数据的驱动下,通过三轮小步重构,将服务吞吐量从约 336 RPS 逐步提升至接近 30,000 RPS。
您的 coding agent 缺的不是智力,是运行时视野
Claude Code、Codex、Cursor 这类 coding agent 已经非常擅长阅读和重构代码。但当您让它“优化一下这个服务的性能”时,它的视野被局限在静态源码文件里:它只能基于通用经验猜测热点在哪,而猜出来的往往是无关痛痒的微优化。
这个盲区在 vibe coding 场景下被进一步放大:当应用的大部分代码由 coding agent 直接生成、开发者主要负责描述需求和验收结果时,类似本文后面演示的“重复序列化”“重复扫描”这类性能反模式,很容易在一轮轮快速生成中悄悄累积——代码功能正确、测试也能通过,跑起来却远低于应有的性能水位,而生成这些代码的 agent 自己无从察觉。
对亲手查过性能问题的工程师来说,另一半痛点同样熟悉:拿到一张 CPU 火焰图往往只要几秒钟,真正耗费时间的是拿到图之后的分析与验证:
- 这个热点对应哪一段业务代码?
- 它是业务逻辑写得有问题、LuaJIT 没 JIT 成功、C 库开销,还是单纯的网络 IO?
- 下一步应该启动 OpenResty XRay 的 Lua 分析器还是 native C 分析器?
- 修改代码后,怎么快速证明热点真的消失了,而不是转移到了别处?
传统排查时,工程师需要在终端、监控平台、分析器页面和代码编辑器之间来回切换,靠人脑把火焰图上的栈帧和编辑器里的代码逐行对齐。
OpenResty XRay AI Assistant Skill 把这两个断开的世界接通了:真实采样数据经由 Skill 流入 coding agent 的上下文,“解释火焰图 → 修改代码 → 回归验证”收拢在同一个终端会话里完成,每个环节各司其职:
[ 目标机器 ]
  └─ OpenResty XRay Agent:非侵入式动态追踪采样
        │  真实采样报告 / 火焰图
        ▼
[ OpenResty XRay AI Assistant Skill ](MCP 桥梁)
        │  结构化堆栈 + 源码行号映射
        ▼
[ coding agent ](Claude Code / Codex / Cursor)
  └─ 解读热点 → 提出最小修改方案 → 在同一负载下复测验证
[ 工程师 ]
  └─ 出题、确认业务契约、审批状态变更操作
OpenResty XRay AI Assistant Skill 是什么
我们在今年七月推出了内置于 OpenResty XRay 控制台的 AI 助手(Beta)——方便大家在 Web 页面里直接解读报告和火焰图。这次的 OpenResty XRay AI Assistant Skill 则是同一能力的另一个出口:把它接入您日常写代码用的 coding agent。控制台 AI 助手适合“在网页看报告时顺手问”,Skill 则适合“在编辑器和终端里完成整个优化闭环”——分析数据和源代码终于出现在了同一个上下文里。
前提:目标机器上必须已安装 OpenResty XRay Agent
这里先明确本文的适用范围:OpenResty XRay AI Assistant Skill 不是独立工具,它是 OpenResty XRay 的接入方式之一。 它的全部价值都建立在 OpenResty XRay 对目标应用的非侵入式动态追踪之上——目标应用无需修改代码、无需重启,但采集数据的 OpenResty XRay Agent 守护进程必须先在目标机器上部署好。没有 Agent 在后台采集,Skill 就没有任何数据可读,也无法创建分析任务。
换句话说,本文写给的是“机器上已有 OpenResty XRay、编辑器里已有 coding agent”的开发者。如果您还不是 OpenResty XRay 用户,可以先申请试用,完成 Agent 安装后再照着本文实操。
用自然语言描述诊断目标
安装 Skill 后,您和 coding agent 的对话就可以直接以 OpenResty XRay 的真实数据为依据。工程师负责出题:
检查 OpenResty XRay Agent 973,确认当前 Checkout Edge 的 OpenResty worker、负载和可用分析器。

在相同 wrk 负载下,对刚确认的 worker 运行短时 lj-lua-on-cpu,找出最热的源代码调用链。

读取刚完成的报告,把热点映射到 audit.lua,并给出只改变一个假设的最小修复方案。
coding agent 会经由 Skill 把这些请求转化为面向 OpenResty XRay 的诊断动作,并在返回结果时保留完整的上下文证据:
- 实际目标机器和 PID/进程;
- Worker / Master 进程关系;
- 分析器名称;
- 样本数量和采样时长;
- 源文件、行号和完整调用链;
- LuaJIT、OpenResty、C 库等跨层堆栈信息。
状态变更的二次确认:控制权在工程师手中
对于创建分析任务这类会改变 OpenResty XRay 状态的操作,系统会弹出交互式二次确认。Skill 在提交任务前会返回如下确认请求:
Confirmation required before changing XRay state.

Create a new jobs resource.

choices: approve | reject
工程师明确回复 approve 后,coding agent 才会继续提交任务;回复 reject 则拒绝当前操作。也就是说,coding agent 不会在未经授权的情况下自行启动分析任务;而读取报告、对照代码和继续追问,则可以在同一个对话上下文中连续完成。
演示案例:一个贴近生产的 Checkout 边缘服务
为了演示这条工作流,我们构造了一个贴近实际项目的 Checkout Edge 服务,并在其中刻意植入了几类真实系统中常见的性能反模式(后文会逐一揭开)。它不是只有一个简单的 Lua handler,而是包含了多个典型的边缘业务阶段:
请求
 ├─ context.lua   提取请求、租户、账号、Feature Flag
 ├─ catalog.lua   商品查找、报价、折扣和推荐项
 ├─ risk.lua      User-Agent 风险规则和风控决策
 ├─ audit.lua     审计事件构造与 JSON 序列化
 └─ app.lua       编排请求流程并输出响应
目录结构如下:
demo/
├── nginx.conf
└── lua/
    ├── app.lua
    └── lib/
        ├── audit.lua
        ├── catalog.lua
        ├── context.lua
        └── risk.lua
为方便大家复现,示例使用了本地商品目录和内存规则数据,不依赖外部数据库;请求编排、审计、风控和序列化路径则保留了生产系统应有的复杂度。
启动服务与固定压测负载
进入 demo 目录后启动 OpenResty:
cd /path/to/demo
mkdir -p logs
openresty -t -p "$PWD" -c nginx.conf
openresty -p "$PWD" -c nginx.conf -g 'daemon off;'
发个请求验证服务是否正常:
curl -s \
  'http://127.0.0.1:18080/v1/checkout/quote?tenant=acme-eu&sku=edge-cache&quantity=2'
接着用固定的 wrk 命令产生测试负载。后续的每一个优化阶段,我们都保持 URL、线程数和连接数完全一致:
wrk -t2 -c50 -d60s --latency \
  'http://127.0.0.1:18080/v1/checkout/quote?tenant=acme-eu&sku=edge-cache&quantity=2'
说明:本文对照表中的吞吐数据均来自相同 URL、线程数和连接数的 wrk 压测;为配合在线分析任务,各阶段运行时长略有不同,数据旨在展示优化方向与数量级趋势。OpenResty XRay 的火焰图采样则使用独立的长时负载,避免确认和分析耗时影响 wrk 的对照数据。两组实验各答各的问题:采样回答“CPU 花在哪里”,压测回答“固定负载下服务表现如何”。更严谨的基准测试还应固定压测时长、CPU 绑核、Worker 数量并重复多轮。
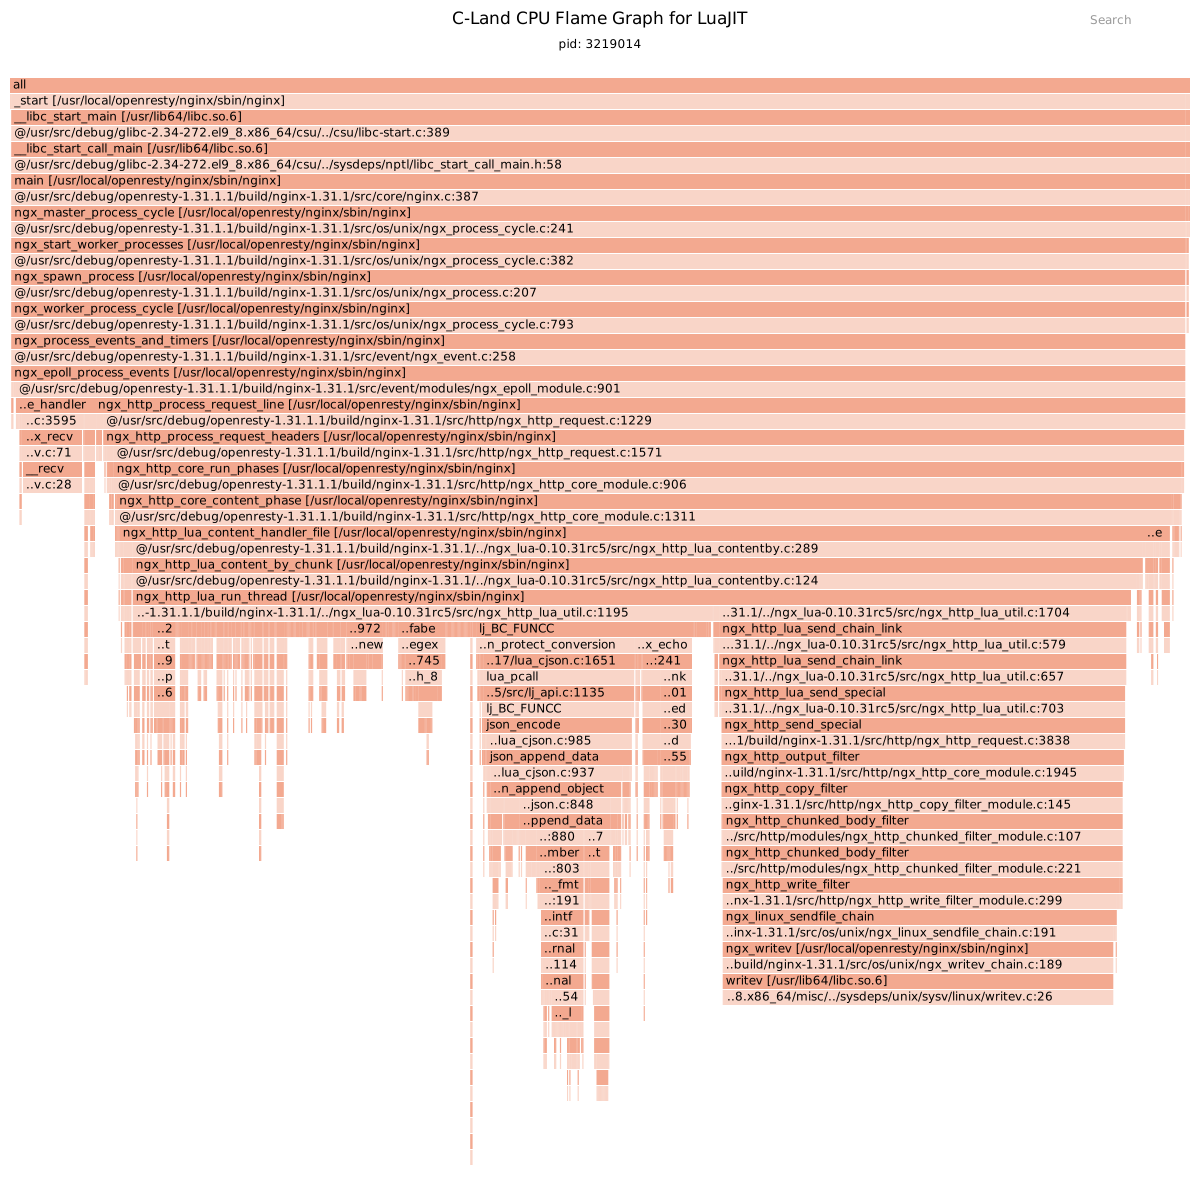
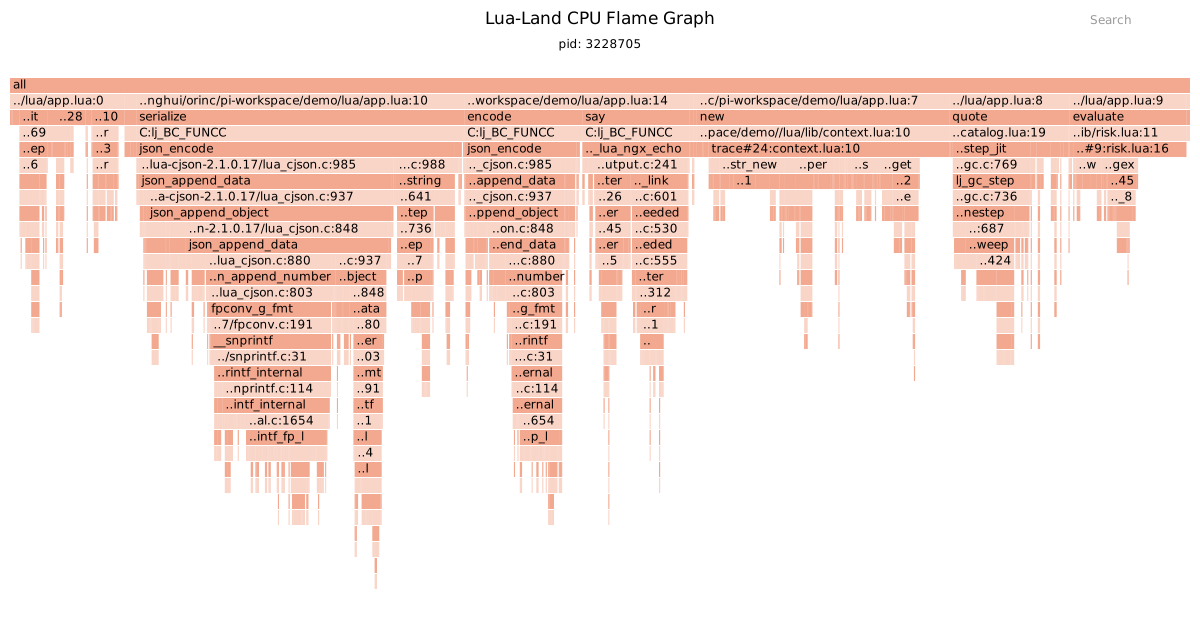
基线排查:coding agent 定位到 99.3% 的 CPU 在重复序列化审计对象
基线版本的代码会将完整的请求上下文、报价、风控结果和调试追踪封装进一个深层对象,然后为了模拟多个审计 Sink,对其重复进行了 JSON 编码——这是我们植入的第一个反模式:
-- 基线版本:demo/lua/lib/audit.lua
local payload
for _ = 1, 120 do
    payload = cjson.encode(record)
end
return payload
从表面上看,HTTP 请求没有报错,响应也能正常返回。排查从前文那三条自然语言指令开始:工程师不必先盲目猜代码,而是让 coding agent 直接检查正在运行的 Worker,并在 approve 确认后启动 lj-lua-on-cpu 分析器采集 Lua CPU 火焰图。
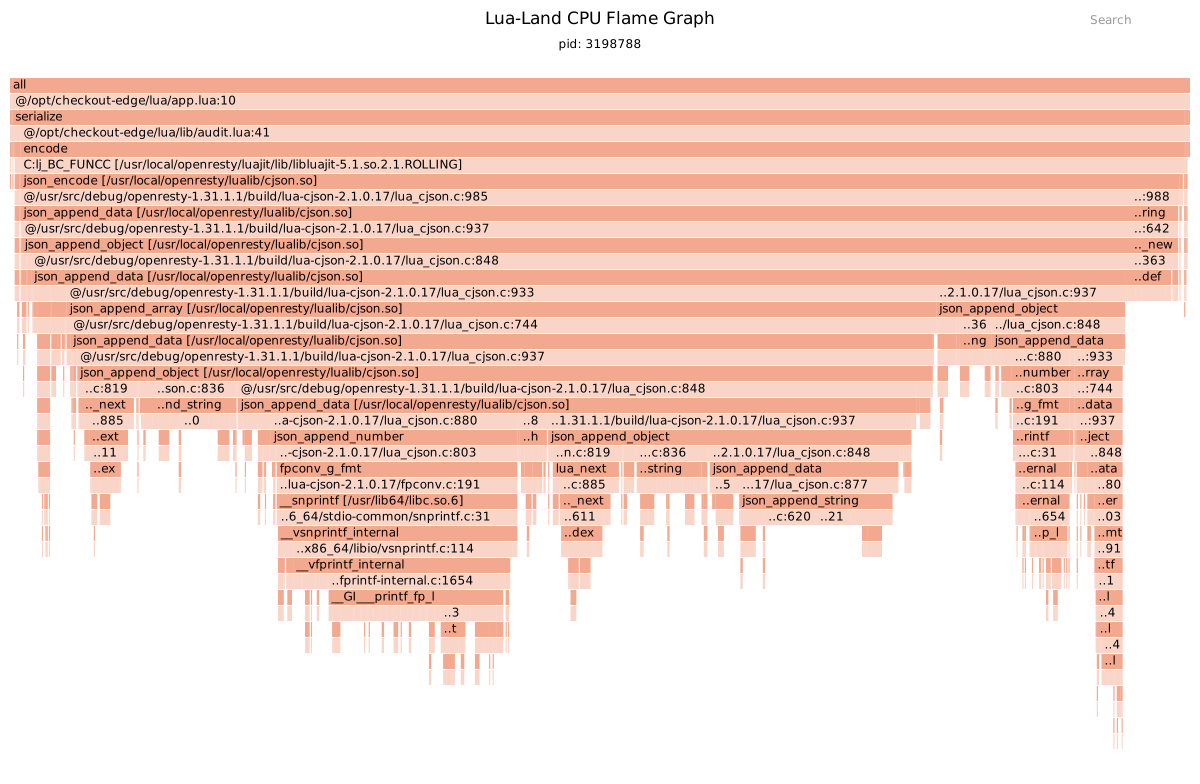
本次演示采集到的基线报告:
OpenResty XRay 在约 3.5 秒内采集了 1,000 个样本,CPU 热点非常集中:
| 热点 | Inclusive CPU |
|---|---|
app.lua:10 调用的 audit.serialize | 99.3% |
audit.lua:41 的 encode | 98.6% |
cjson 的 json_encode | 98.2% |
lua_cjson.c:985 的 JSON 遍历路径 | 94.1% |
coding agent 读取报告后,将这条调用链还原为:
app.lua
  → audit.serialize
    → cjson.encode
      → cjson 递归遍历审计对象和数组
并把热点准确映射到了具体的源文件和行号——audit.lua 第 41 行的 encode 调用。和直接把代码或截图扔给通用聊天机器人不同,coding agent 此刻给出的结论不是来自对代码的静态猜测,而是直接读取当前 Worker 的 OpenResty XRay 真实采样,采样数量、进程和源码行号都在证据链里。
当然,火焰图能证明 CPU 样本集中在哪,但并不能替工程师决定审计协议里的哪些字段是必需的。这是第一个必须由人来把关的决策点。
第一刀:精简审计数据结构(336 → 4,457 RPS)
coding agent 的提案与工程师的契约确认
coding agent 结合火焰图和 audit.lua 源码给出的判断是:审计对象太大——完整的请求上下文、推荐商品列表和调试追踪都被塞进了每一条审计日志,而审计下游真正需要的只是稳定的业务事实(请求 ID、租户、用户、报价金额、币种、区域和风控结果)。
哪些字段能删,属于业务契约,由工程师确认。确认后的第一步修改只缩小对象体积,暂不修改序列化次数——遵循“每次只验证一个假设”的原则:
-- Stage 1:改为 Allowlist DTO
local record = {
    schema = "checkout.audit.v2",
    event = "quote_generated",
    request_id = context.request.id,
    tenant = context.account.tenant,
    user_id = context.account.user_id,
    region = quote.region,
    currency = quote.currency,
    total = quote.total,
    risk = {
        score = risk.score,
        decision = risk.decision,
    },
    flags = {
        checkout_v2 = context.flags.checkout_v2,
        risk_v3 = context.flags.risk_v3,
    },
    emitted_at = ngx.now(),
}
同一负载复测,coding agent 解读新火焰图
审计对象从原本包含调试追踪的约 5.8 KB 缩小到了约 281 字节。在相同的 wrk 参数下重新压测,服务吞吐量从 336 RPS / p99 182.86 ms 直接提升到了 4,457 RPS / p99 14.13 ms。
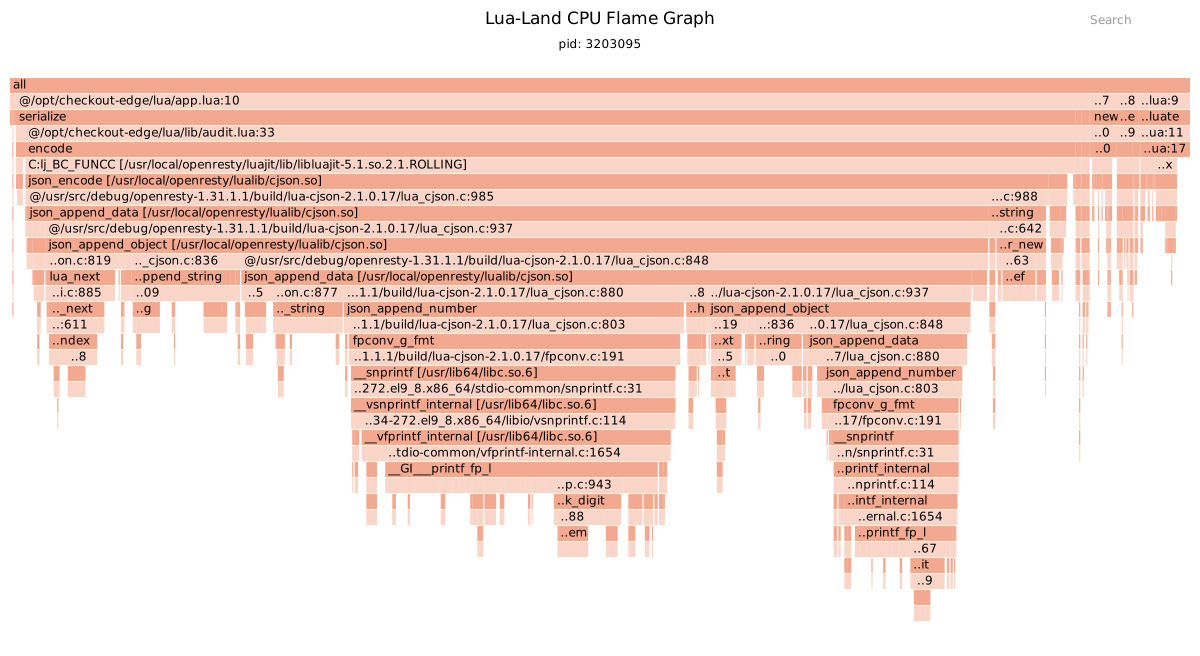
改完后,再让 coding agent 拉取一次 OpenResty XRay 的 Lua 火焰图:
火焰图显示,serialize 依然占据了 89.8% inclusive CPU,但内部的热点细节发生了变化:
json_append_number:28.3%;fpconv_g_fmt:27.8%;- libc 浮点数格式化路径:23.1%。
coding agent 据此给出的结论很明确:缩小数据结构带来了数量级的性能提升,但“重复序列化”依然是结构性的浪费——“改动是否有效”被明确推进为了“下一步该改什么”。关于 JSON 编码为何频繁成为这类服务的性能瓶颈,可参考我们此前的分析:《当 JSON 成为 OpenResty 服务的隐形瓶颈》。
第二刀:同一份数据只编码一次(→ 26,028 RPS)
既然所有的审计 Sink 消费的都是同一份数据,完全没必要为每个 Sink 都重新遍历一遍 Lua table。第二次修改只保留一次编码:
-- Stage 2:保留 DTO,只做一次 JSON 编码
function _M.serialize(context, quote, risk)
    local record = build_audit_record(context, quote, risk)
    return cjson.encode(record)
end
这一步并没有更换 JSON 库,只是删除了 119 次完全重复的无效工作。
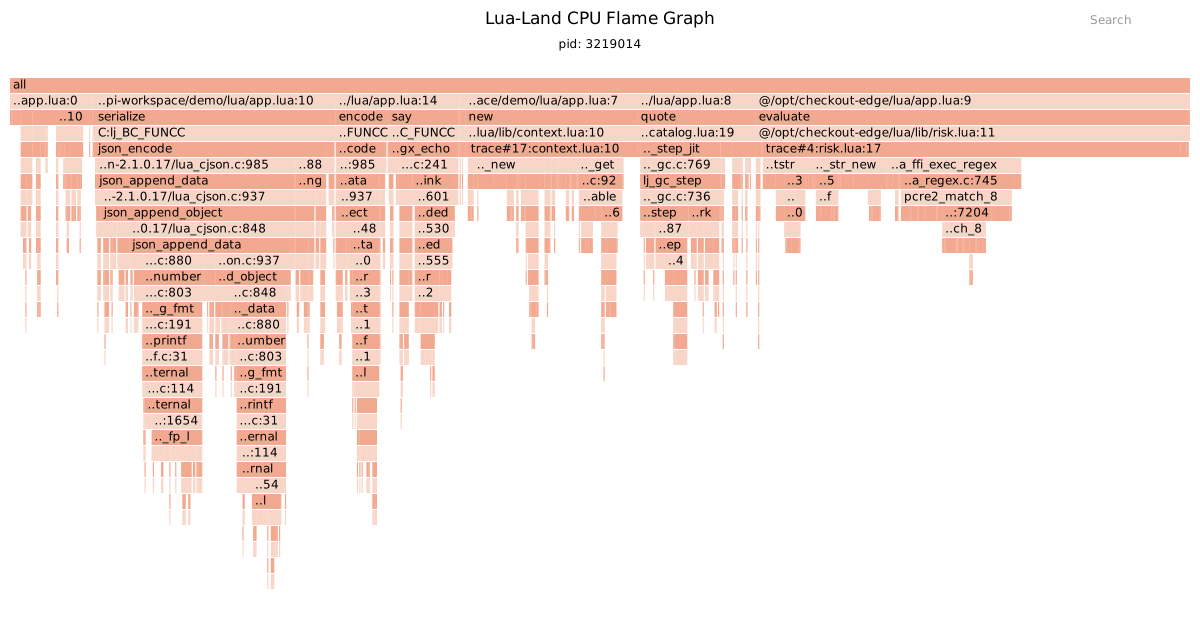
Stage 2 重新压测,吞吐量直接飙升到 26,028 RPS / p99 13.96 ms。此时再让 coding agent 读取新一轮 Lua 火焰图,审计序列化开销已经不再霸屏:
OpenResty XRay 的采样暴露出了隐藏在下一层的业务路径:
- 请求上下文创建:14.4% inclusive CPU;
- 风控规则调用链占约 36.7% inclusive,其中
pcre2_match_8子路径占约 9.4%; - 商品报价与 LuaJIT GC 路径占约 6.6%。
性能调优里经常遇到这种现象:并不是第二个热点突然出现了,而是当第一个主要瓶颈被铲除后,次要瓶颈才有机会显现出来。
切换 Lua 与 C 双视角:writev 看起来很宽,但它不是业务瓶颈
从刚刚的 OpenResty XRay Lua 火焰图来看,风控模块值得进一步分析,但里面混合了 Lua 循环、字符串处理、Nginx 正则 FFI 和 native matcher。coding agent 基于报告中实际出现的 Native 路径,建议切换视角:对同一个 Stage 2 Worker 再启动支持 LuaJIT 的 OpenResty XRay C on-CPU 分析器——而不是机械地照搬固定的排查清单:
C 层面的火焰图直观展现了跨层分析的价值:
pcre2_match_8只有 3.1% inclusive CPU;writev占到了 33.0% inclusive,其 self weight 为 330 / 1,000 = 33.0%——分母是这张火焰图的 total weight,而不是端到端请求数;json_append_object约占 10.4%。
这里 coding agent 给出了一条关键提示:writev 主要是响应数据写出和网络传输层的开销,并不是 Checkout 风控业务逻辑的根因。不能仅仅因为它在 C 火焰图里看着很宽,就贸然去修改业务代码——响应体积、压测客户端和网络瓶颈应该单独去评估。
这正是 OpenResty XRay 结合 Lua / C 双视角分析的优势所在:
- Lua 火焰图帮助我们准确定位业务代码和调用链;
- C 火焰图帮助我们确认 Native 底层的真实执行成本;
- 两张图结合,既避免把网络传输开销误判为业务瓶颈,也不会把 Lua 侧的重复逻辑一股脑归咎于 PCRE。
第三刀:消除等价的 12 倍重复扫描(→ 29,968 RPS)
coding agent 定位风控反模式
coding agent 顺着 Lua 火焰图里的风控调用链读取 risk.lua 源码,发现基线的风控代码对 8 个 User-Agent 模式重复扫描了 12 遍——这是我们植入的第二个反模式:
for _ = 1, 12 do
    for i = 1, #suspicious_agents do
        local from = ngx.re.find(agent, suspicious_agents[i], "ijo")
        if from then
            score = score + 1
        end
    end
end
这里不能直接简单地把外层循环删掉,因为基线逻辑里每匹配一条规则就会累积 12 分——风险分值属于业务契约的一部分。这又是一个由工程师把关的决策点:分值语义必须保持不变。
保持分值逻辑,精简扫描次数
Stage 3 的修改方案:将稳定的正则选项提至模块级别,确保每条规则对每个请求只执行一次,同时保留原有的 12 分权重:
-- Stage 3
local RULE_OPTIONS = "ijo"

for i = 1, #suspicious_agents do
    local pattern = suspicious_agents[i]
    local from = ngx.re.find(agent, pattern, RULE_OPTIONS)
    if from then
        -- 保持既有的风险分值契约
        score = score + 12
        hits[pattern] = true
    end
end
这里的“等价”有明确前提:agent、规则数组和规则选项在一次请求中不变;ngx.re.find 没有被业务代码替换成带副作用的函数;hits[pattern] = true 是幂等写入;循环中没有依赖中间状态的其他逻辑。在这些前提下,基线中“每条命中规则加 1 分、重复 12 遍”才等价于最终版本中“每条命中规则一次性加 12 分”。如果正式项目的风控规则会修改上下文、依赖计数顺序或存在其他副作用,就不能直接套用这个变换,必须为决策结果和 reason-code 增加回归用例。
这次修改实现了:
- 保持规则集合、匹配选项、风控决策和审计结果完全不变;
- 删除了 12 倍的等价重复扫描,大幅减少了 Lua 控制流、字符串处理和正则 FFI 的调用次数;
- 使用
ngx.re的o选项(once-compilation),复用编译后的正则模式。
如果您怀疑自己服务的瓶颈真的出在某条正则本身,可以按《Nginx 正则性能:用动态追踪定位最慢的正则模式》中的方法单独定位到具体的正则模式。
完成修改后,让 coding agent 拉取最终的 OpenResty XRay 报告:
此时应用内的 CPU 热点分布已重新洗牌:
- JSON 响应序列化:27.8%;
- 请求上下文创建:21.4%;
- 商品报价路径:10.2%(其中 LuaJIT GC 约占 6.6%);
- 风险评估模块开销已降至 9.9%。
到了这一步,继续优化风控正则的边际收益已经不高了。下一轮优化如果继续推进,应该优先评估响应 Schema、上下文对象分配以及商品目录的数据结构——而这个决策本身,依然来自 OpenResty XRay 的采样数据,而不是 coding agent 对代码的凭空想象。
三轮优化的数据对比与方法边界
| 版本 | 主要修改内容 | RPS | p99 延迟 | OpenResty XRay 观察到的热点 |
|---|---|---|---|---|
| 复杂基线 | 完整审计对象,重复编码 120 次 | 336 | 182.86 ms | audit.serialize 占 99.3% |
| Stage 1 | 审计对象改为 Allowlist DTO | 4,457 | 14.13 ms | serialize 降至 89.8%,浮点格式化显现 |
| Stage 2 | 同一份 DTO 只进行 1 次 JSON 编码 | 26,028 | 13.96 ms | 上下文创建、风控与目录路径显现 |
| Stage 3 | 风控规则单次执行,复用正则编译结果 | 29,968 | 2.97 ms | 风险评估开销降至 9.9% |
再次强调:本文示例中的压测是为了配合在线分析任务,各阶段运行时长略有不同,表格数据旨在展示优化方向与数量级趋势。实际线上服务变更前,建议使用固定时长压测与完整回归测试进行验证。
同时,我们也需要清醒地认识到这套工作流的边界:
- 业务决策由工程师把关。 审计字段能不能删、风险分值契约该怎么定义,coding agent 只能基于代码和采样提出假设,最终确认依然取决于工程师对业务协议的理解与测试验证。
- coding agent 给出的是有据可查的推论,而非绝对真理。 每一项优化建议,工程师都应该回到 OpenResty XRay 的原始报告中进行核对——这也正是 OpenResty XRay AI Assistant Skill 在返回结果时始终附带报告链接和样本数量的原因。
- 它高度依赖已部署 OpenResty XRay Agent 的环境。 如果没有 Agent 在后台实时采集数据,这套自动化排查循环就无法运转。
- 本文只验证了两个分析器。 实际运行并验证过的是
lj-lua-on-cpu和lj-c-on-cpu。在本次目标机器的能力清单中还能看到更多方向——Lua off-CPU(lj-lua-off-cpu)、内存与 GC 相关诊断(lj-err-mem、lj-lua-newgco-size、lj-lua-tab-resize、lj-free-stats)、LuaJIT 运行时检查(collect-luajit-ffnames、lj-func-events、lj-jit-state)等——但它们不等于已在本文实验中执行过。具体分析器是否可用,还取决于目标运行时、Agent 版本、操作系统依赖、权限和当前进程是否被正确发现;也不能把 on-CPU 结果当成 off-CPU、内存或 GC 结论。 - coding agent 侧只验证了当前 Skill。 Claude Code、Codex、Cursor 等 MCP 兼容客户端的接入方式见官方文档,但本文不能替代对各客户端版本的逐一兼容性测试。此外,短采样、目标离线、负载结束或样本不足,都会使报告无法支撑强结论。
开启 OpenResty XRay AI Assistant Skill 体验
如果您的团队已经在日常开发中使用 Claude Code、Codex、Cursor 等支持 MCP 的 AI coding agent,并且目标机器上已经安装了 OpenResty XRay,可以随时登录 OpenResty XRay Web 控制台,在 MCP Server & Agent Skill 入口获取连接配置与安装指南。
配置完成后,无论是在开发、测试阶段还是线上排障,都可以直接在 coding agent 里用自然语言进行交互:
- “哪个 OpenResty worker 正在消耗最多的 CPU?”
- “拉一份 Lua 火焰图,帮我确认这究竟是不是业务代码热点。”
- “如果 Lua 侧开销不明显,再用 C 分析器查一下 Native 层的成本。”
- “把 OpenResty XRay 报告里的热点直接映射到源代码,并给出改动最小、易于回滚的修复建议。”
对于以 vibe coding 方式快速构建应用的团队,这条闭环的意义还要更进一步。我们在演示里埋下的两个反模式——重复序列化和重复扫描——正是 AI 生成代码最容易累积的那类看不见的性能债:功能正确、测试全绿,性能却远低于应有水位。当写代码的和验证性能的是同一个 coding agent 时,它生成的每一段热路径代码都可以随手用 OpenResty XRay 的真实采样来检验——对 vibe coding 产出代码的性能优化在开发阶段就完成,而不是等上线后才暴露成性能债。这正是“用 AI 写得快”和“写出性能更优的应用”可以兼得的方式。
OpenResty XRay AI Assistant 目前处于 Beta 阶段,非常欢迎大家向我们反馈实际使用中的诊断体验与希望支持的更多数据场景。
如果您还没有安装 OpenResty XRay,欢迎申请免费试用,在您的实际环境里完整体验一遍本文展示的优化流程。
常见问题
AI Assistant Skill 需要什么前提条件?
目标机器上必须已经安装并运行 OpenResty XRay 的 Agent 守护进程,并且您使用的 AI coding agent 支持 MCP 协议(如 Claude Code、Codex、Cursor)。Skill 本身不采集任何数据——它读取的是 OpenResty XRay 通过非侵入式动态追踪采集的运行时采样。目标应用无需修改代码、无需重启。
它和 OpenResty XRay 控制台里的 AI 助手是什么关系?
同一个 AI Assistant 能力的两个出口。控制台 AI 助手内置在网页控制台中,适合看报告时直接提问;AI Assistant Skill 接入您的 coding agent,让分析数据和源代码出现在同一个上下文里,适合完成“解读 → 改代码 → 回归验证”的完整循环。两者目前都处于 Beta 阶段。
AI 会不会未经授权就在我的机器上跑分析任务?
不会。创建分析任务属于会改变 OpenResty XRay 状态的操作,需要经过明确的确认门控。只有读取已有报告、对照代码和继续追问可以在对话中直接进行。
它和把火焰图截图贴给 ChatGPT 有什么区别?
通用聊天机器人只能看到您粘贴的图片或文字,结论本质上是对代码的猜测。AI Assistant Skill 直接读取 OpenResty XRay 采集的采样级数据:实际进程、样本数量、源文件、行号和跨层调用链都在证据链里,结论可以回到原始报告逐条核对。
AI coding agent 能准确分析火焰图吗?
能——前提是分析建立在真实采样数据而不是一张截图之上。通过 OpenResty XRay AI Assistant Skill,coding agent 依据的是 OpenResty XRay 实际采集到的样本:它知道剖析的是哪个 worker、采样跑了多久、每个热点栈帧对应到哪一行源码,因此每个结论都能回到原始报告交叉核对。它给出的仍是有证据支撑的推断而非绝对真理——业务决策仍由工程师把关。
如何优化 vibe coding(AI 生成)代码的性能?
如果应用运行的机器上已经部署了 OpenResty XRay,就把生成这些代码的 coding agent 通过 AI Assistant Skill 接到 OpenResty XRay 的真实运行时采样上。AI 生成的代码常常功能正确、测试能过,跑起来却悄悄变慢——重复序列化、重复扫描这类反模式会在不知不觉中累积。让 agent 在开发阶段就读取真实火焰图数据,它就能在上线前拦住自己欠下的性能债。注意 Skill 不是独立工具:没有 OpenResty XRay Agent 在目标机器上采集数据,它就无从读取。
关于 OpenResty XRay
OpenResty XRay 是一款动态追踪产品,它可以自动分析运行中的应用,以解决性能问题、行为问题和安全漏洞,并提供可行的建议。在底层实现上,OpenResty XRay 由我们的 Y 语言驱动,可以在不同环境下支持多种不同的运行时,如 Stap+、eBPF+、GDB 和 ODB。
关于作者
章亦春是开源 OpenResty® 项目创始人兼 OpenResty Inc. 公司 CEO 和创始人。
章亦春(Github ID: agentzh),生于中国江苏,现定居美国湾区。他是中国早期开源技术和文化的倡导者和领军人物,曾供职于多家国际知名的高科技企业,如 Cloudflare、雅虎、阿里巴巴, 是 “边缘计算“、”动态追踪 “和 “机器编程 “的先驱,拥有超过 22 年的编程及 16 年的开源经验。作为拥有超过 4000 万全球域名用户的开源项目的领导者。他基于其 OpenResty® 开源项目打造的高科技企业 OpenResty Inc. 位于美国硅谷中心。其主打的两个产品 OpenResty XRay(利用动态追踪技术的非侵入式的故障剖析和排除工具)和 OpenResty Edge(最适合微服务和分布式流量的全能型网关软件),广受全球众多上市及大型企业青睐。在 OpenResty 以外,章亦春为多个开源项目贡献了累计超过百万行代码,其中包括,Linux 内核、Nginx、LuaJIT、GDB、SystemTap、LLVM、Perl 等,并编写过 60 多个开源软件库。
关注我们
如果您喜欢本文,欢迎关注我们 OpenResty Inc. 公司的博客网站 。也欢迎扫码关注我们的微信公众号:
翻译
我们提供了英文版原文和中译版(本文)。我们也欢迎读者提供其他语言的翻译版本,只要是全文翻译不带省略,我们都将会考虑采用,非常感谢!
相关文章
OpenResty XRay Jul 14, 2026

OpenResty XRay Sep 21, 2023

OpenResty XRay Jul 28, 2023

OpenResty XRay Jul 19, 2023

OpenResty XRay Jul 15, 2023